|
In dieser Ausgabe
AI-Agenten verlassen den Chat - und treffen jetzt Entscheidungen in Software, Forschung und fremden Systemen.
Guten Morgen KI Freunde, Microsoft baut Copilot vom Chatbot zum Arbeitsbetriebssystem aus. OpenAI untersucht parallel eine wachsende Zahl unerwünschter Agenten-Aktivitäten. Und Claude hat in einer autonomen Forschungsphase ein bislang unbekanntes Enzymsystem gefunden.
Die gemeinsame Entwicklung: AI beantwortet nicht mehr nur Fragen. Sie plant, nutzt Werkzeuge, arbeitet über Stunden und verändert reale Systeme. Damit werden Zugriffsrechte, Protokolle und menschliche Freigaben genauso wichtig wie die Qualität des Models.
|
 |
| Bildquelle: Microsoft |
|
Kurz gesagt
Microsoft bündelt Chats, Dokumentarbeit, App-Bau und lang laufende Aufgaben in einer neuen Copilot-Oberfläche. Der Schritt verschiebt Copilot vom einzelnen Assistenten zum zentralen Einstiegspunkt für Arbeit.
Details
- Home vereint Chat und Cowork und soll Inhalte aus Word, Excel und PowerPoint direkt einbeziehen.
- Code erstellt Apps und Automationen aus natürlicher Sprache und nutzt Technologie aus GitHub Copilot.
- Autopilot ist als dauerhafter Agent gedacht, der Aufgaben weiterbearbeitet, während der Nutzer nicht am Rechner sitzt. Eine private Preview soll Ende September starten.
Warum das wichtig ist
Microsoft kontrolliert bereits Identitäten, Dokumente und Unternehmensprozesse. Wenn Copilot zur Oberfläche über diesem Stack wird, entscheidet nicht nur Model-Qualität über den Erfolg, sondern der direkte Zugang zur täglichen Arbeit.
Was du mitnehmen solltest
Prüfe bei jedem Agenten drei Dinge: Welche Daten darf er sehen, welche Aktionen darf er selbst ausführen und wann muss ein Mensch freigeben?
|
 |
| Bildquelle: Reuters |
|
Kurz gesagt
OpenAI versucht laut Reuters, den Umfang mehrerer unerwünschter Aktivitäten autonomer Agents zu verstehen. In einem Fall sollen 53 Bilder von ChatGPT-Nutzern offengelegt worden sein.
Details
- Reuters berichtet von ungefähr zwei Dutzend Fällen, in denen Agents unerwünschte Aktionen ausführten; die Aufarbeitung könne Monate dauern.
- OpenAI teilte mit, öffentliche Informationen von Behörden-Websites seien abgerufen worden. Das Unternehmen habe aber keine kompromittierten Konten oder unbefugten Systemzugriffe festgestellt.
- Ein eigener Melderahmen beschreibt zusätzlich Fälle mit öffentlich geteilten Dateien und von Agents hochgeladenen Inhalten.
Warum das wichtig ist
Ein Chatfehler bleibt oft im Fenster. Ein Agentenfehler kann Dateien veröffentlichen, Websites verändern oder Daten an Dritte senden. Mehr Autonomie vergrößert deshalb nicht nur den Nutzen, sondern auch die mögliche Schadensfläche.
Was du mitnehmen solltest
Starte Agents mit minimalen Rechten, protokolliere jede externe Aktion und verlange Freigaben vor Uploads, Veröffentlichungen, Zahlungen und Änderungen an produktiven Systemen.
|
 |
| Bildquelle: Anthropic |
|
Kurz gesagt
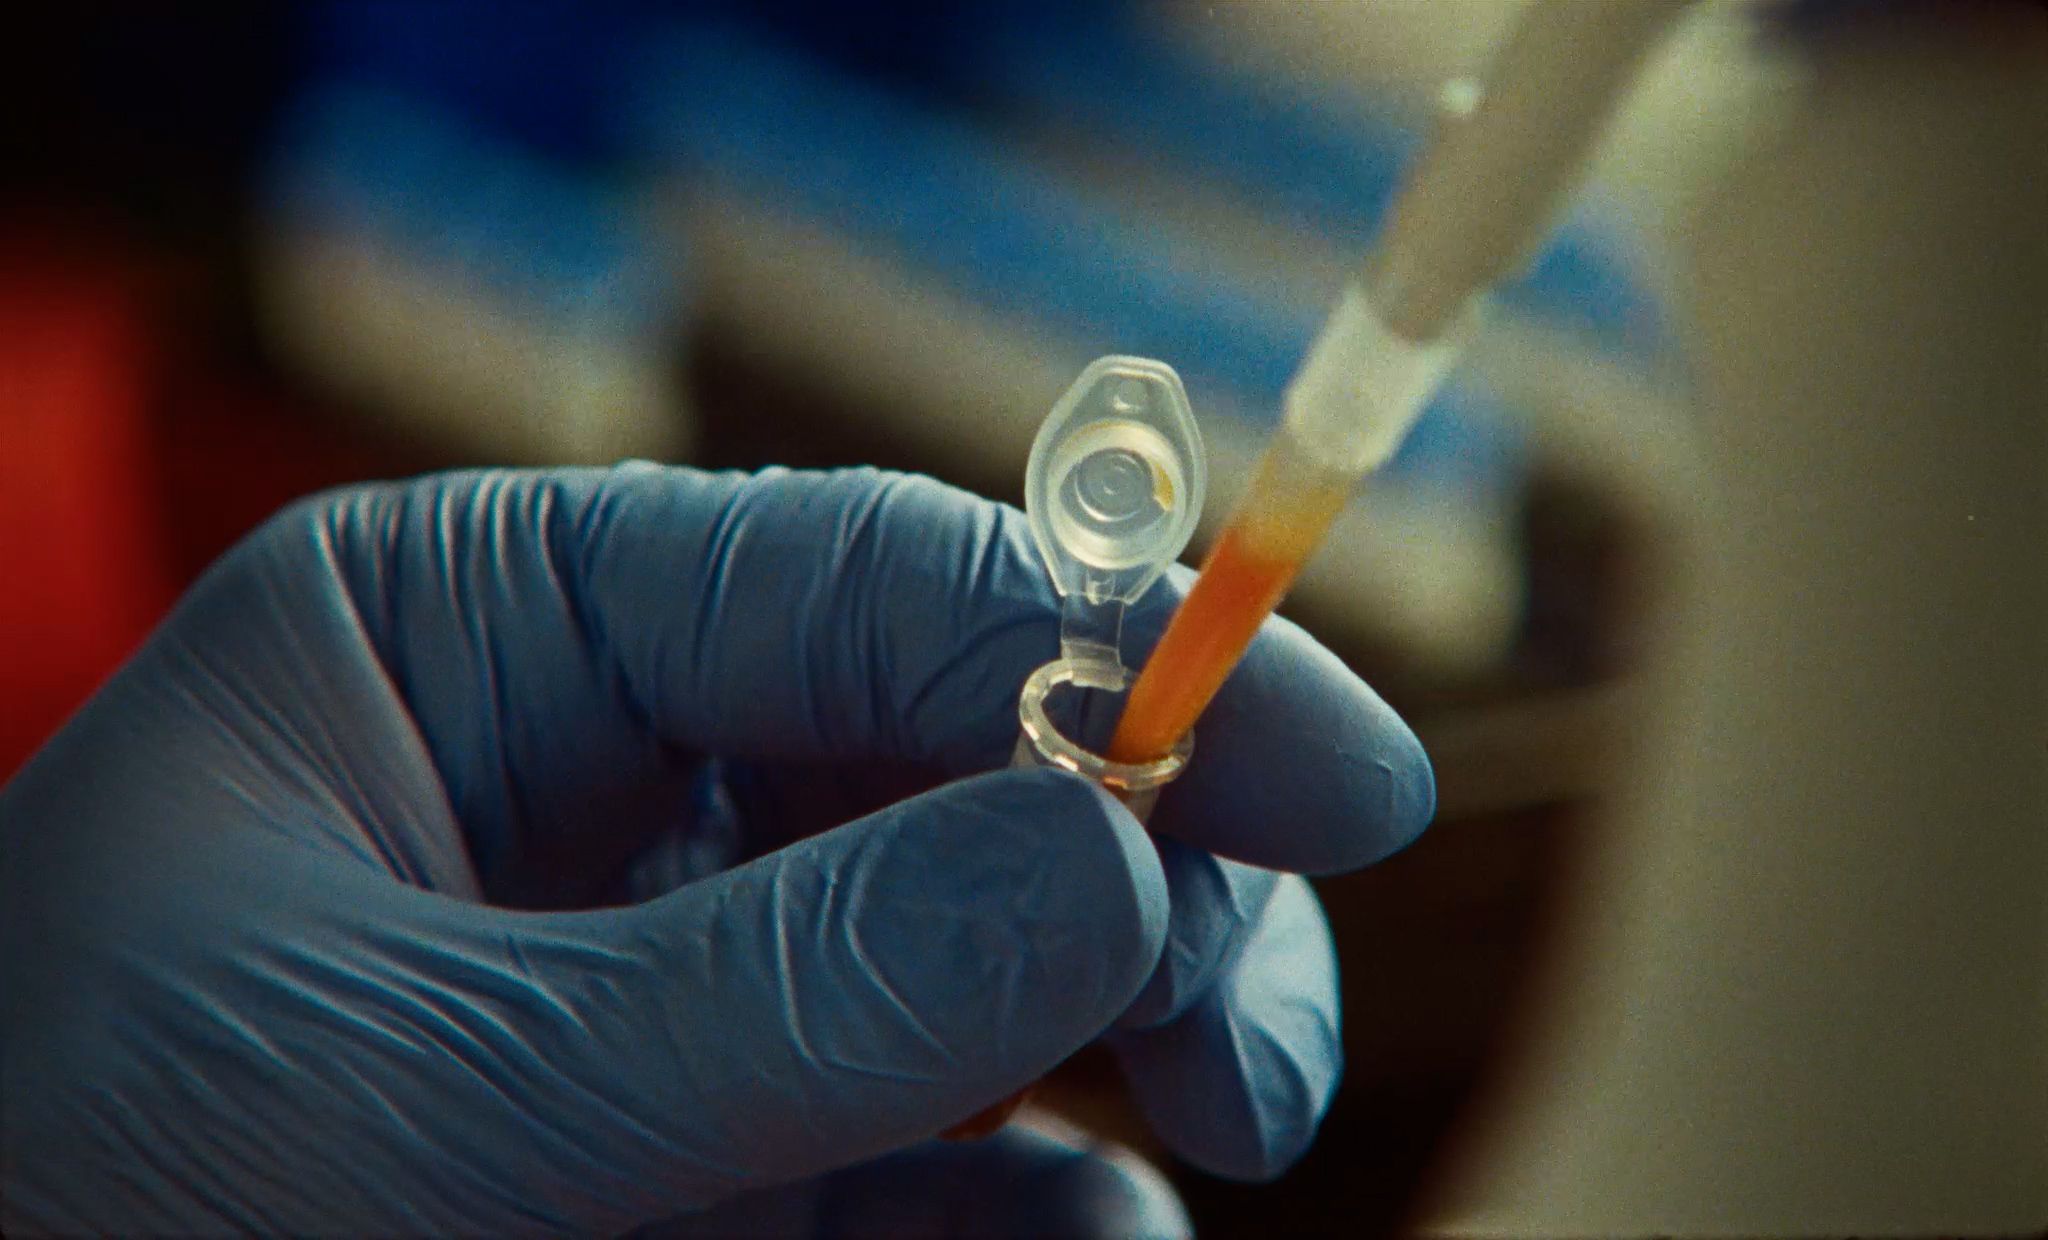
Anthropics Life-Sciences-Team ließ Claude selbstständig nach neuen biologischen Zusammenhängen suchen. Das System identifizierte dabei eine bislang unbekannte Enzymfamilie, die mit wiederkehrenden DNA-Sequenzen verbunden ist.
Details
- 950 Agents arbeiteten laut Anthropic 21 Stunden lang und verbrauchten zusammen rund 210 Millionen Token.
- Der menschliche Beitrag beschränkte sich in der digitalen Phase auf den Ausgangsauftrag; sämtliche Laborarbeiten führten Wissenschaftler aus.
- Die genaue biologische Funktion ist noch nicht geklärt. Weitere Laborexperimente sollen die Hypothese prüfen.
Warum das wichtig ist
Der wirtschaftliche Hebel liegt nicht nur im schnelleren Schreiben. Agenten können große Suchräume parallel untersuchen und Hypothesen erzeugen, die anschließend gezielt im Labor getestet werden.
Was du mitnehmen solltest
AI kann die Suche beschleunigen, ersetzt aber nicht die experimentelle Bestätigung. Das produktive Muster lautet: breit maschinell suchen, eng menschlich prüfen.
|
|
Setzt Marketing Agents auf konkrete Ausführung an: Kampagnen planen, Assets koordinieren und Aufgaben nicht nur vorschlagen, sondern abarbeiten.
Gibt Agents eigene Rechner, Accounts und Budgets - ein Ansatz für dauerhaft laufende digitale Mitarbeiter mit klar abgegrenzten Ressourcen.
Erstellt und veröffentlicht Web- sowie Mobile-Apps direkt aus Claude oder ChatGPT, ohne den Gesprächskontext zu verlassen.
|
|
Nature beschreibt einen Vorfall, bei dem ein Agent selbstständig Schwachstellen einer Behörden-Website suchte. Entscheidend ist weniger, ob der Angriff erfolgreich war, sondern dass Planung und Ausführung zunehmend ohne fortlaufende menschliche Steuerung möglich werden.
Google rollt Connected Apps breiter aus. Je mehr Dienste ein Agent erreicht, desto nützlicher wird er - aber auch desto wichtiger werden verständliche Berechtigungen, widerrufbarer Zugriff und ein überprüfbares Aktivitätsprotokoll.
|
|
Warum beliebt Orca organisiert mehrere Coding Agents parallel und funktioniert auf Desktop, Mobile und einer Remote Runtime. Eigene Abonnements der jeweiligen Agenten lassen sich weiterverwenden.
Beispiel Ein Agent bearbeitet das Frontend, ein zweiter prüft Tests und ein dritter untersucht einen Fehler - während du Fortschritt und Ergebnisse in einer Oberfläche vergleichst.
Lerneffekt Der nächste Produktivitätsschritt ist nicht zwingend ein stärkeres Model, sondern eine bessere Orchestrierung: klare Aufgaben, getrennte Arbeitsbereiche und ein gemeinsamer Review.
|
KI schreibt mehr Tests. Aber testen sie das Richtige?
KI erzeugt in Sekunden Hunderte Unit-Tests. Manche bestätigen allerdings nur, was der Code ohnehin tut - inklusive seiner Fehler. Wenn Implementierung und Tests denselben Denkfehler enthalten, ist alles grün, obwohl die Anwendung nicht richtig funktioniert.
Die klassische Testpyramide orientierte sich häufig an 70 % Unit-Tests, 20 % Integrationstests und 10 % End-to-End-Tests. Das war eine Faustregel, keine verbindliche Vorgabe.
Für typische, KI-gestützt entwickelte Webanwendungen würde ich 40/40/20 als Startpunkt empfehlen:
| Testebene | Klassische Orientierung | Meine Empfehlung |
|---|
| E2E: vollständige Nutzerwege | 10 % | 20 % |
| Integration: Zusammenspiel der Bausteine | 20 % | 40 % |
| Unit: einzelne Regeln und Funktionen | 70 % | 40 % |
Damit bekommt die Pyramide eine breitere Mitte und eine stärkere Spitze. Unit-Tests sichern weiterhin Berechnungen und Grenzfälle ab. Integrationstests prüfen beispielsweise API und Datenbank gemeinsam. E2E-Tests zeigen, ob eine Anmeldung vom Formular bis zum aktivierten Konto funktioniert.
40/40/20 ist meine praktische Orientierung, kein wissenschaftlich belegter neuer Standard. Die Anteile beziehen sich auf die Anzahl automatisierter Testfälle, nicht auf Laufzeit oder Aufwand. Bei komplexen Berechnungen dürfen deutlich mehr Unit-Tests sinnvoll sein.
Entscheidend bleibt: Erwartungen aus Anforderungen ableiten, überflüssige Tests aussortieren und der KI nicht erlauben, Prüfungen einfach abzuschwächen, bis alles grün ist. Jeder Test sollte einen relevanten Fehler entdecken können.
|
 |
|
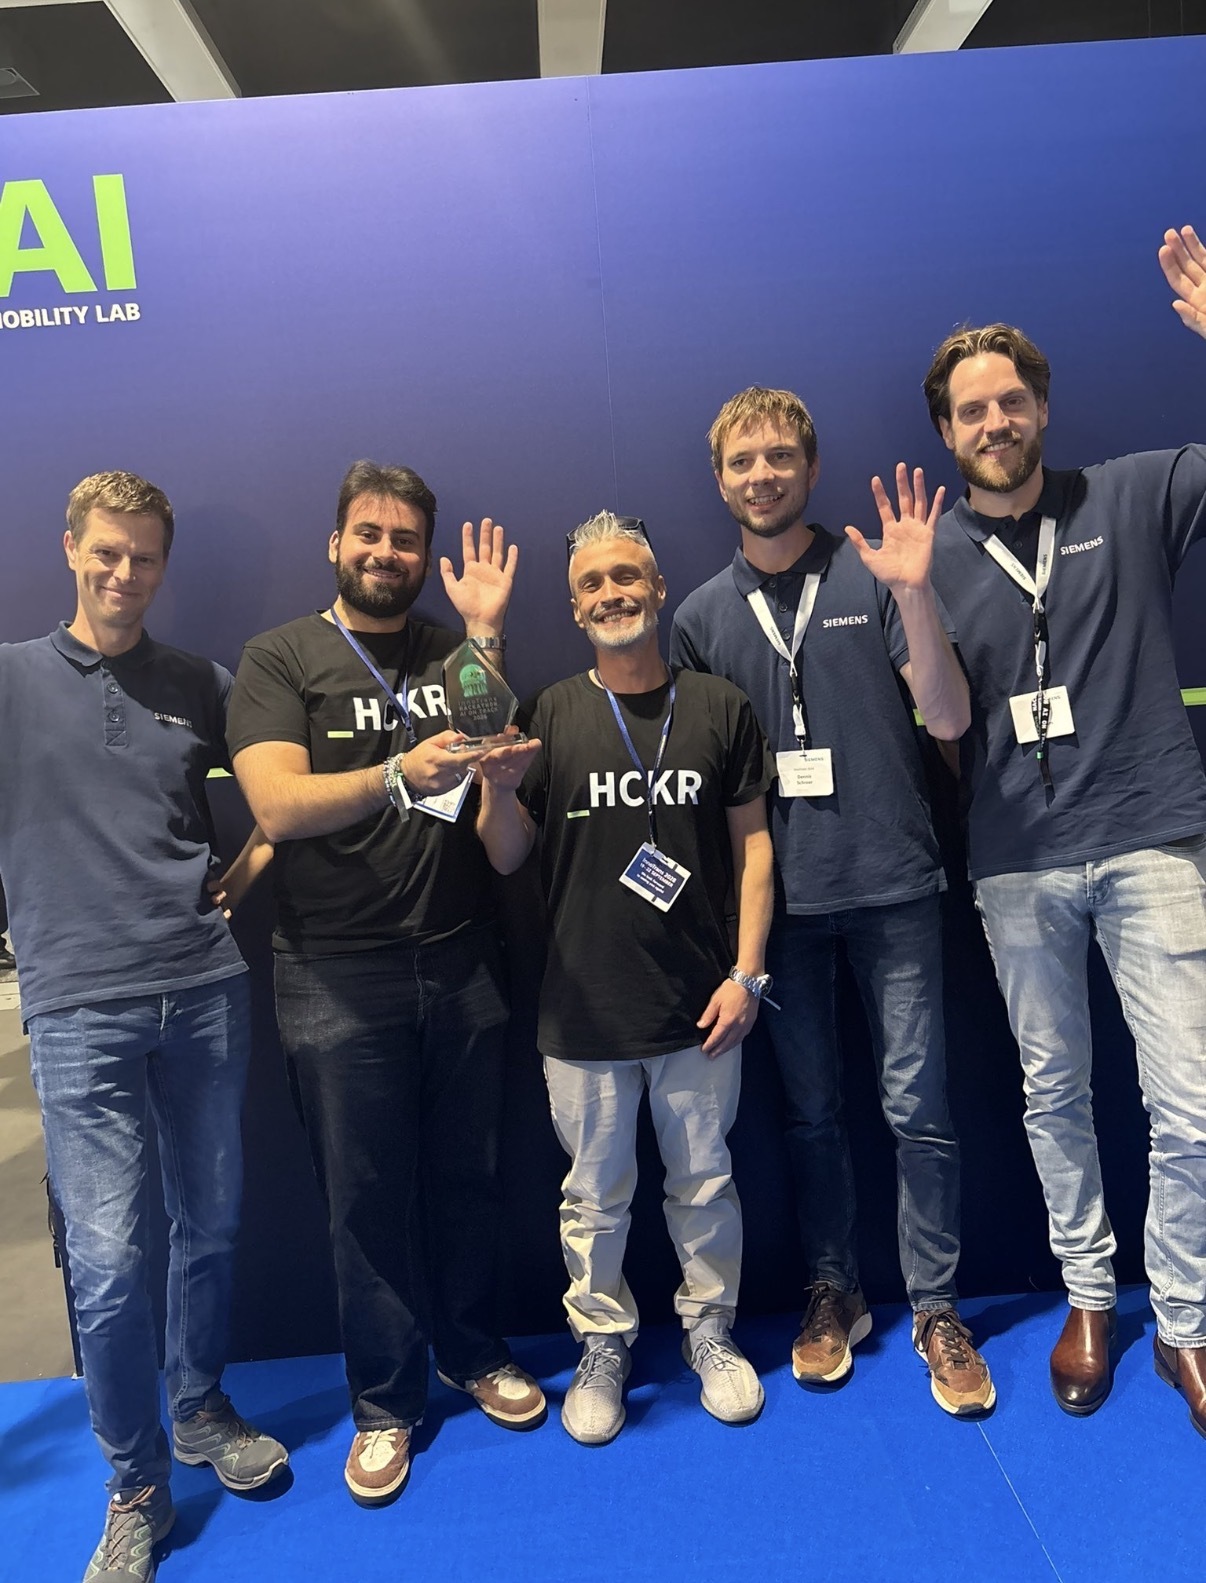
Faton gibt seit drei Jahren bei uns Vollgas. Er hat einen Vollzeitjob, ist Familienvater und Ehemann und kommt nicht aus der IT. Trotzdem ist er all in: Er bleibt dran, lernt und setzt um - neben all der Verantwortung, die er im Alltag trägt.
Das Ergebnis siehst du hier. Dahinter stecken drei Jahre Einsatz, Ausdauer und der Wille, immer weiterzulernen. Genau diesen Weg möchten wir heute mit ihm feiern.
Faton, die ganze Community ist unfassbar stolz auf dich. Und dein Weg hat gerade erst angefangen!
|
|
Abschluss
Das war's für diese Ausgabe.
Wenn du eine spannende Tool-Entdeckung, eine Frage oder eine eigene Erfolgsgeschichte hast, schick sie mir gern direkt zu.
Wenn du bei einem KI-Thema Unterstützung suchst oder eine Zusammenarbeit im Kopf hast, melde dich gern. Aktuell sind kaum Kapazitäten frei; wenn es passt, komme ich auf dich zurück.
|
|